


















Data Deduplication là gì? Các loại khử trùng lặp dữ liệu và lợi ích
Đã kiểm duyệt nội dung
Đánh giá
Data Deduplication là quá trình xác định và loại bỏ các khối dữ liệu trùng lặp trong hệ thống, chỉ giữ lại một phiên bản duy nhất cùng các tham chiếu tương ứng. Bài viết này được đúc kết từ kinh nghiệm thực tế triển khai và quản trị hệ thống lưu trữ dữ liệu, giúp mình hiểu rõ những vấn đề phát sinh khi dữ liệu trùng lặp tích tụ theo thời gian. Cùng mình phân tích chi tiết cơ chế hoạt động và cách ứng dụng kỹ thuật này để tối ưu không gian lưu trữ hiệu quả.
Những điểm chính
- Quan điểm của mình: Dưới góc độ quản trị hạ tầng, Data Deduplication là một giải pháp kỹ thuật thiết yếu. Việc loại bỏ dữ liệu trùng lặp giúp doanh nghiệp cắt giảm trực tiếp chi phí lưu trữ, tối ưu hóa băng thông truyền tải và rút ngắn đáng kể thời gian khôi phục hệ thống (RTO) khi xảy ra sự cố.
- Data Deduplication là gì: Nắm vững định nghĩa và mục tiêu của quá trình loại bỏ bản ghi trùng lặp để chỉ giữ lại một phiên bản duy nhất trong cơ sở dữ liệu.
- Tại sao cần khử trùng lặp dữ liệu: Xác định nguyên nhân hình thành dữ liệu thừa và tác động tiêu cực đến không gian lưu trữ cũng như tính toàn vẹn thông tin.
- Lợi ích của việc loại bỏ dữ liệu trùng lặp: Đánh giá hiệu quả tiết kiệm chi phí, cải thiện tốc độ truy xuất và tối ưu hóa năng lực quản trị hạ tầng.
- Cơ chế hoạt động Data Deduplication như thế nào: Hiểu rõ các bước phân tách khối dữ liệu, tạo mã băm (hashing) và đối chiếu để triển khai chính xác trên hệ thống.
- Hạn chế và rủi ro tiềm ẩn của Data Deduplication: Nhận diện những rào cản về hiệu năng xử lý (overhead) và rủi ro toàn vẹn dữ liệu khi tiến hành đối chiếu khối lượng lớn thông tin.
- Các trường hợp cần sử dụng Data Deduplication: Xác định các môi trường ưu tiên áp dụng như hệ thống sao lưu thứ cấp (secondary storage), lưu trữ đám mây và cơ sở dữ liệu khách hàng.
- Các tiêu chí lựa chọn giải pháp Data Deduplication: Xây dựng bộ quy chuẩn để định hình phương pháp triển khai tự động, thủ công hoặc ngăn chặn từ nguồn phù hợp với kiến trúc hệ thống.
- Hạ tầng lưu trữ Vietnix: Nắm bắt giải pháp máy chủ NVMe Tier 3 giúp tối ưu hiệu năng xử lý và an toàn cho hệ thống Data Deduplication.
- Câu hỏi thường gặp: Cung cấp các hướng dẫn xử lý nhanh những vấn đề kỹ thuật và tình huống thực tiễn phát sinh trong quá trình loại bỏ dữ liệu dư thừa.
Data Deduplication là gì?
Data Deduplication (khử trùng lặp dữ liệu) là quá trình phát hiện và loại bỏ các bản sao dữ liệu trùng lặp trong một hệ thống lưu trữ, nhằm đảm bảo chỉ giữ lại một phiên bản duy nhất của mỗi mảng thông tin. Về bản chất kỹ thuật, đây là một dạng công nghệ nén dữ liệu không mất mát. Thay vì lưu trữ nhiều bản ghi hoặc khối dữ liệu giống hệt nhau, phần mềm sẽ chỉ lưu lại một bản vật lý gốc và sử dụng các con trỏ để tham chiếu cho những lần xuất hiện tiếp theo của cùng một dữ liệu đó.
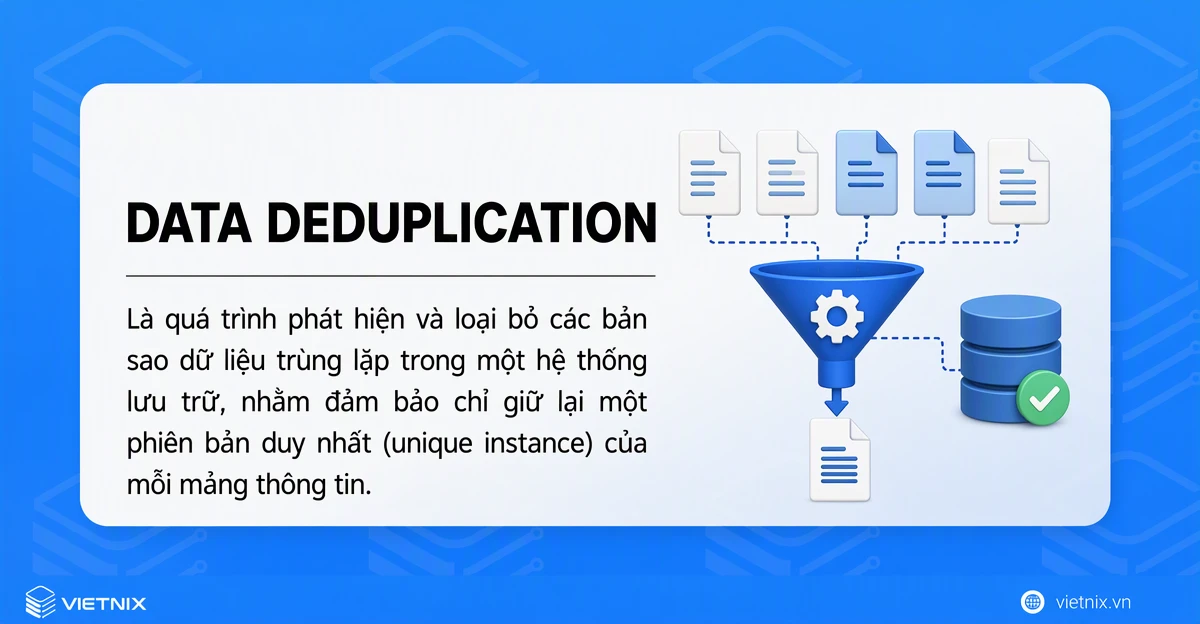
Kỹ thuật này được áp dụng rộng rãi trong quản trị cơ sở dữ liệu, hệ thống sao lưu và hạ tầng lưu trữ đám mây. Việc thực hiện Data Deduplication giúp doanh nghiệp tối ưu hóa dung lượng không gian đĩa cứng, tiết kiệm chi phí băng thông mạng khi đồng bộ hệ thống và duy trì tính toàn vẹn, chính xác cho kho dữ liệu hiện hành.
Việc ứng dụng kỹ thuật khử trùng lặp dữ liệu giúp tối ưu không gian lưu trữ, nhưng để giải quyết bài toán về chi phí mở rộng khi quản lý khối lượng dữ liệu khổng lồ lại là một thách thức không nhỏ đối với nhiều hệ thống. Để kiểm soát ngân sách hiệu quả và lưu trữ an toàn lượng dữ liệu sau khi tinh gọn, bạn có thể triển khai giải pháp S3 Object Storage của Vietnix. Dịch vụ lưu trữ này giúp doanh nghiệp loại bỏ hoàn toàn các khoản phí ẩn nhờ chính sách miễn phí 100% chi phí băng thông (ingress & egress) và phí request API. Bên cạnh đó, S3 Object Storage của Vietnix còn ứng dụng thuật toán Erasure Coding (m+2) kết hợp cơ chế High Availability phân tán trên nhiều node server độc lập, đảm bảo tính toàn vẹn và an toàn cho hệ thống dữ liệu ngay cả khi hỏng 2 ổ cứng cùng lúc.
Tại sao doanh nghiệp lại có dữ liệu trùng lặp?
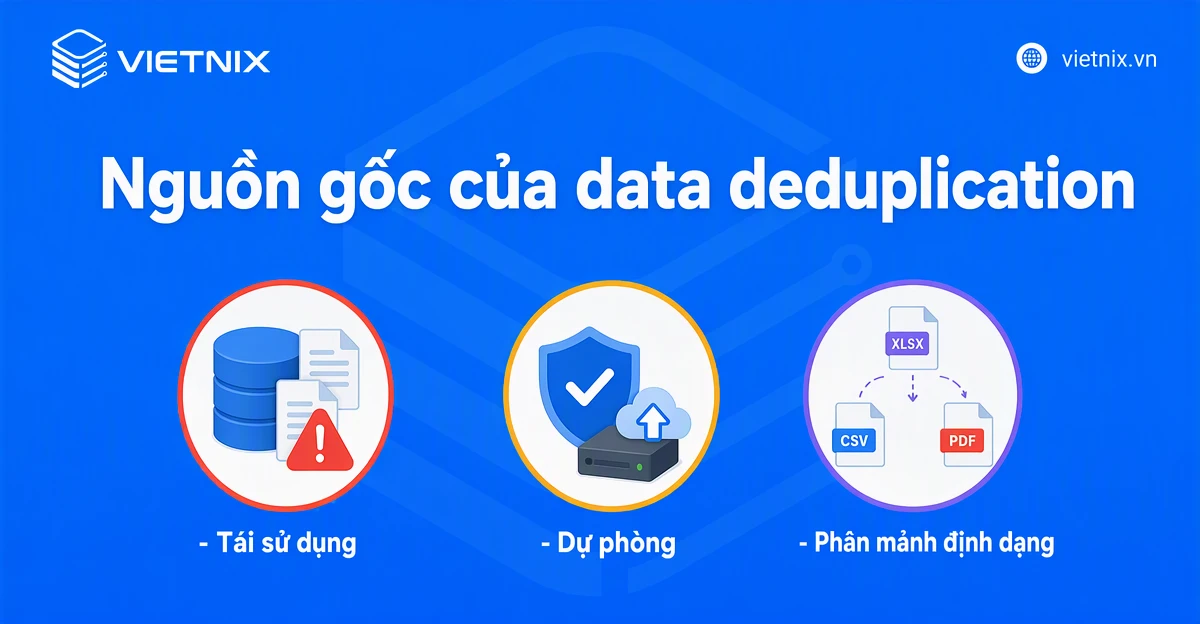
Việc dữ liệu bị trùng lặp là hệ quả tất yếu từ các nhu cầu vận hành thực tế của doanh nghiệp, bao gồm:
- Tái sử dụng: Các phòng ban dùng lại dữ liệu gốc cho nhiều mục tiêu khác nhau.
- Dự phòng: Chủ động lưu giữ nhiều bản sao để ứng phó với rủi ro mất mát dữ liệu.
- Phân mảnh định dạng: Lưu trữ cùng một nội dung nhưng dưới nhiều định dạng tệp khác nhau trong quá trình phối hợp liên phòng ban.
Bản thân việc tạo ra bản sao không phải là lỗi hệ thống. Bài toán cốt lõi nằm ở sự bành trướng dữ liệu mất kiểm soát (data proliferation). Tình trạng rác dữ liệu dư thừa trực tiếp bào mòn ngân sách IT, buộc tổ chức phải liên tục đốt chi phí và nguồn lực vào việc mở rộng hạ tầng lưu trữ vật lý hoặc nâng cấp các gói Cloud đắt đỏ.
Lợi ích của việc loại bỏ dữ liệu trùng lặp là gì?
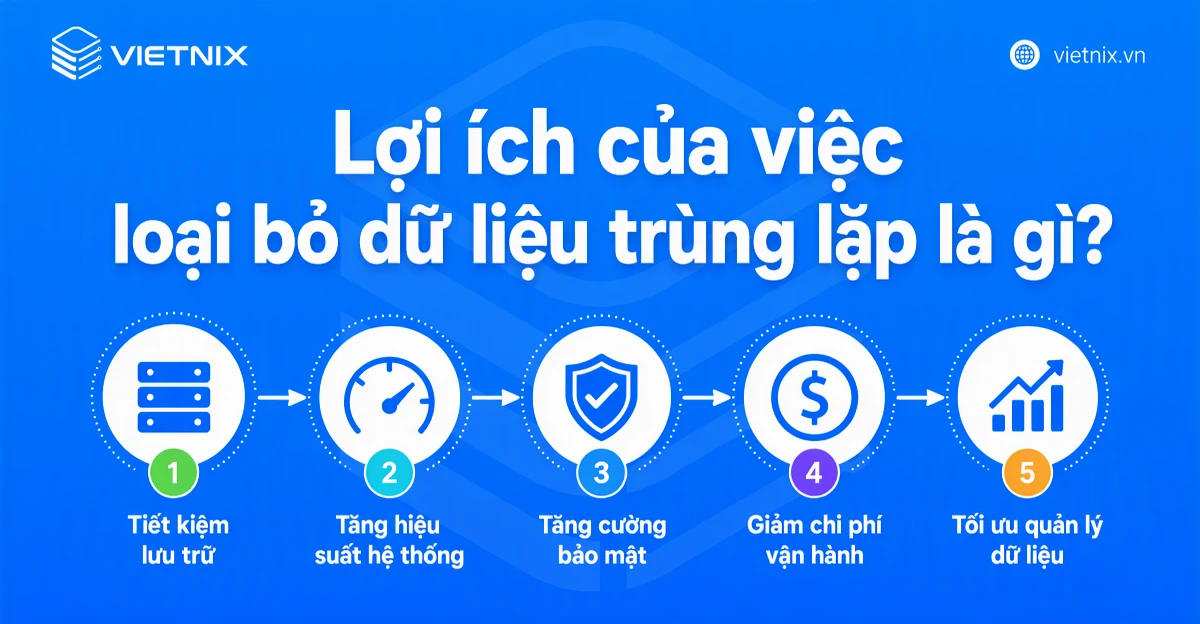
Quá trình Data Deduplication tác động trực tiếp đến hiệu quả vận hành hạ tầng IT. Triển khai phương pháp này mang lại nhiều giá trị kỹ thuật và tài chính, giúp hệ thống hoạt động ổn định, loại bỏ tài nguyên dư thừa và nâng cao chất lượng dữ liệu.
1. Tiết kiệm không gian lưu trữ
Việc triển khai Data Deduplication giúp doanh nghiệp loại bỏ hoàn toàn các khối dữ liệu trùng lặp, từ đó giảm thiểu đáng kể dung lượng lưu trữ yêu cầu. Hiệu quả này giúp tổ chức tiết kiệm không gian đĩa vật lý cho các cụm máy chủ dự phòng, đồng thời giảm tải mức tiêu thụ tài nguyên điện toán và băng thông mạng trong suốt quá trình rà soát và thực thi tác vụ sao lưu.
2. Tối ưu Khôi phục sau thảm họa (Disaster Recovery)
Công nghệ khử trùng lặp làm giảm kích thước tổng thể của các bản sao lưu, qua đó trực tiếp rút ngắn thời gian khôi phục hệ thống (RTO) khi xảy ra sự cố gián đoạn. Việc trích xuất các bản backup với dung lượng nhỏ giúp cụm máy chủ xử lý giảm bớt áp lực tài nguyên, đảm bảo quá trình phục hồi dịch vụ diễn ra nhanh chóng và duy trì tính liên tục cho hoạt động kinh doanh.
3. Rút ngắn khung thời gian sao lưu
Giải pháp khử trùng lặp thu gọn tối đa kích thước của luồng dữ liệu cần sao lưu, giúp cắt giảm thời gian xử lý và mức tiêu hao tài nguyên phần cứng. Nhờ đó, đội ngũ IT có thể linh hoạt thiết lập lịch trình sao lưu thường xuyên hơn mà không gây ảnh hưởng đến năng lực xử lý của hệ thống vận hành thực tế.
4. Nâng cao hiệu suất network
Quá trình luân chuyển dữ liệu với dung lượng thấp sẽ làm giảm tải áp lực lên băng thông của hệ thống mạng. Bằng cách chỉ đóng gói và truyền tải các khối dữ liệu độc bản, Data Deduplication tối ưu hóa hiệu suất mạng diện rộng, đặc biệt hiệu quả trong các tác vụ nặng như đồng bộ dữ liệu về kho lưu trữ dài hạn hoặc gọi lại dữ liệu phục vụ quy trình khôi phục thảm họa.
5. Tiết kiệm chi phí
Trước tình trạng bùng nổ khối lượng dữ liệu, công nghệ khử trùng lặp hỗ trợ doanh nghiệp cắt giảm trực tiếp chi phí đầu tư phần cứng bằng cách hạ thấp nhu cầu mở rộng dung lượng cho cả lưu trữ chính và lưu trữ dự phòng. Đồng thời, tổ chức cũng tiết kiệm đáng kể chi phí vận hành nhờ việc giảm tiêu thụ điện năng, làm mát và rút ngắn thời gian nhân sự IT phải tiêu tốn để quản trị hệ thống dữ liệu phân mảnh.
Cơ chế hoạt động Data Deduplication như thế nào?
Về mặt kiến trúc, các hệ thống Khử trùng lặp dữ liệu vận hành dựa trên cơ chế đối chiếu chuỗi nhận dạng duy nhất (mã băm – hash) của các tệp tin hoặc khối dữ liệu. Khi hệ thống xác thực được sự trùng khớp giữa các mã băm, khối dữ liệu dư thừa sẽ được ghi log và loại bỏ. Quy trình xử lý kỹ thuật này bao gồm ba giai đoạn trọng tâm:
- Phân mảnh dữ liệu (Chunking): Ở giai đoạn khởi tạo, hệ thống thực hiện chia cắt các tệp tin thành các khối dữ liệu nhỏ (chunks). Kích thước của các phân đoạn này được xác định tự động bằng thuật toán hoặc thiết lập thủ công theo cấu hình của quản trị viên. Kỹ thuật phân mảnh cung cấp độ chính xác cao trong việc nhận diện bản sao, tuy nhiên quá trình này đòi hỏi hệ thống phải cấp phát lượng lớn tài nguyên tính toán (CPU và RAM) để thực thi.
- Tính toán và gán mã băm (Hashing): Ngay khi dữ liệu được phân mảnh, thuật toán mật mã học sẽ gán một giá trị băm (hash value) duy nhất cho từng phân đoạn. Hệ thống quản trị tiến hành đối chiếu mã băm này với cơ sở dữ liệu chỉ mục (index log) hiện có. Nếu hệ thống xác nhận mã băm đã tồn tại, khối dữ liệu tương ứng sẽ được phân loại là bản sao dư thừa và bị xóa bỏ để giải phóng không gian lưu trữ.
- Thiết lập bảng tham chiếu: Toàn bộ kết quả của tiến trình loại bỏ dữ liệu được hệ thống lưu trữ tập trung vào một bảng tham chiếu. Cấu trúc dữ liệu này theo dõi các phân đoạn đã bị xóa và thiết lập các con trỏ liên kết trực tiếp về khối dữ liệu gốc. Kiến trúc bảng tham chiếu đảm bảo tính toàn vẹn của tập tin, duy trì khả năng truy xuất nguồn gốc và hỗ trợ hệ thống phục hồi chính xác cấu trúc tệp dữ liệu trên toàn bộ phân vùng lưu trữ.
Hạn chế và rủi ro tiềm ẩn của Data Deduplication là gì?
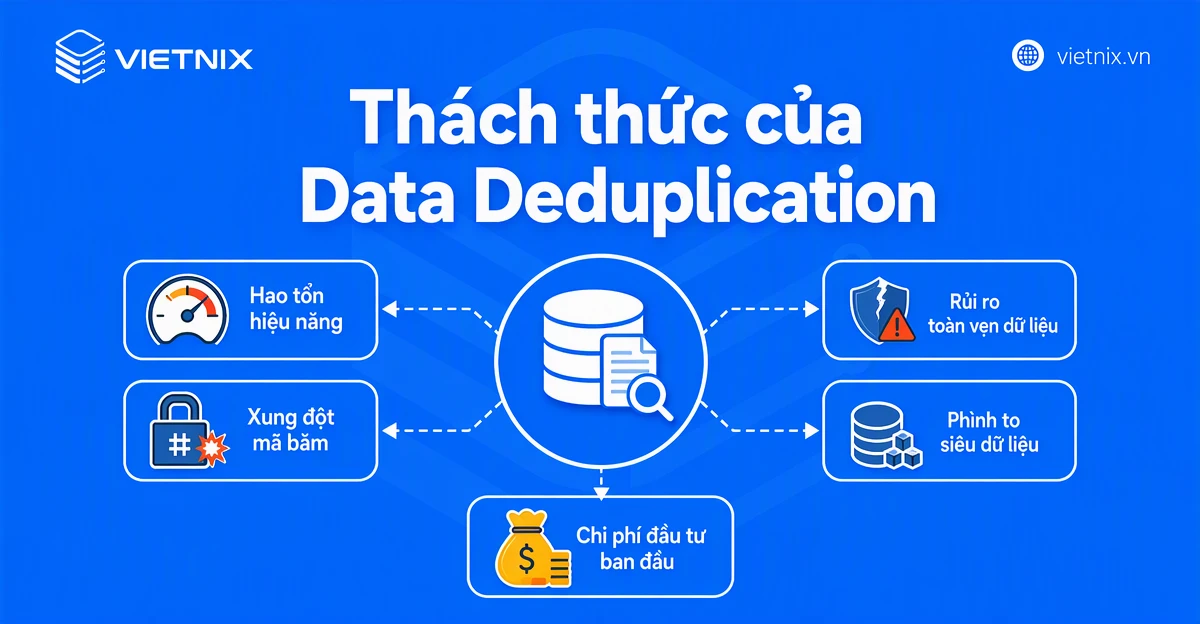
Dù mang lại hiệu quả tối ưu lưu trữ, Data Deduplication vẫn đi kèm các rủi ro vận hành. Hầu hết các hạn chế này bắt nguồn từ yêu cầu tài nguyên điện toán khổng lồ khi hệ thống thực thi khử trùng lặp phân mảnh sâu. Dưới đây là các rủi ro kỹ thuật trọng tâm:
- Hao tổn hiệu năng: Tiến trình khử trùng lặp, đặc biệt ở cấp độ block-level, tiêu thụ lượng lớn tài nguyên CPU và RAM. Quản trị viên bắt buộc phải cấu hình lịch trình nghiêm ngặt dựa trên băng thông khả dụng, tải hệ thống hiện tại và khung thời gian sao lưu để tránh gây nghẽn cổ chai (bottleneck) cho hệ thống vận hành lõi.
- Xung đột mã băm: Hàng tỷ mã băm được sinh ra làm tăng xác suất thuật toán gán chung một giá trị băm cho hai khối dữ liệu khác biệt, dẫn đến rủi ro hỏng hóc dữ liệu. Để khắc phục, hệ thống cần mở rộng bảng băm hoặc dùng các thuật toán phân giải như Chaining hay Open Addressing, kéo theo sự phức tạp lớn trong quản trị cơ sở dữ liệu.
- Rủi ro toàn vẹn dữ liệu: Quá trình tự động hóa luôn tiềm ẩn rủi ro xóa hoặc làm biến đổi dữ liệu độc bản. Nguyên nhân có thể do lỗi khối nguồn, xung đột mã băm, sập nguồn, lỗi phần cứng đĩa hoặc sai sót thao tác. Bất kỳ sự cố nào trong số này đều có thể làm tê liệt khả năng khôi phục hệ thống.
- Phình to siêu dữ liệu: Để theo dõi và đối chiếu, tiến trình tự động sinh ra một lớp siêu dữ liệu chứa chữ ký số của các khối. Lớp siêu dữ liệu này vừa chiếm dụng thêm không gian lưu trữ, vừa tạo ra điểm mù bảo mật: nếu tập tin metadata bị lỗi định dạng, việc trích xuất và phục hồi dữ liệu gốc sẽ trở nên bất khả thi.
- Chi phí đầu tư ban đầu: Dù giảm được chi phí lưu trữ dài hạn, việc tích hợp Deduplication đòi hỏi chi phí đầu tư ban đầu cao. Ngân sách này không chỉ bao gồm bản quyền phần mềm giải pháp (thường tính theo khối lượng bản ghi xử lý), mà còn là chi phí nhân sự IT chuyên môn cao để thiết kế kiến trúc, cấu hình và bảo trì hệ thống liên tục.
Các trường hợp cần sử dụng Data Deduplication là gì?
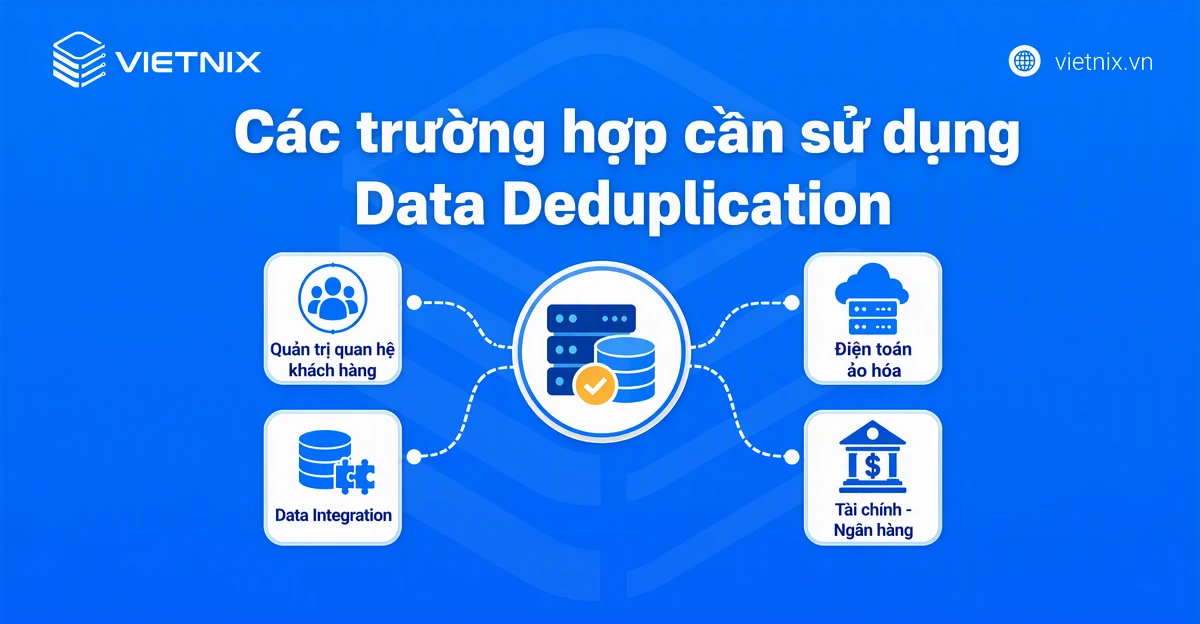
Data Deduplication được ứng dụng rộng rãi trong các hệ thống lưu trữ lớn và quản trị dữ liệu nhằm tối ưu dung lượng hạ tầng và đảm bảo tính vẹn toàn của thông tin. Dưới đây là các trường hợp thực tế mà mình thường thiết lập quá trình khử trùng lặp để duy trì hiệu suất vận hành.
1. Quản trị quan hệ khách hàng (CRM)
Dữ liệu đổ về CRM từ nhiều nguồn khác nhau thường bị phân mảnh và thiếu đồng bộ. Deduplication giải quyết vấn đề này bằng cách hợp nhất các thông tin trùng lặp thành một bản ghi chuẩn xác duy nhất. Điều này đảm bảo mọi phòng ban đều trích xuất, làm báo cáo và phân tích dựa trên cùng một tệp dữ liệu nhất quán.
2. Data Integration
Trong các hoạt động sáp nhập doanh nghiệp hoặc tái cấu trúc hạ tầng, việc hợp nhất các nền tảng ERP độc lập chắc chắn sinh ra lượng lớn bản ghi chồng chéo. Data Deduplication tự động rà soát và triệt tiêu sự trùng lặp này, giúp giải phóng không gian lưu trữ và chuẩn hóa toàn bộ cơ sở dữ liệu của tổ chức mới.
3. Điện toán ảo hóa
Khi vận hành hạ tầng máy tính để bàn ảo hoặc cấp phát các môi trường kiểm thử, các máy ảo liên tục nhân bản các tệp tin hệ điều hành và ứng dụng lõi. Quá trình khử trùng lặp chủ động dọn dẹp các khối dữ liệu dư thừa này, ngăn chặn triệt để tình trạng cạn kiệt dung lượng đĩa và duy trì hiệu năng xử lý ngay cả khi mật độ người dùng tăng đột biến.
4. Tài chính – Ngân hàng
Việc lưu trữ rải rác các hồ sơ khách hàng trùng lặp giữa nhiều chi nhánh tạo ra các lỗ hổng bảo mật nghiêm trọng, tạo điều kiện cho tội phạm đánh cắp danh tính và thực hiện giao dịch gian lận. Triển khai Deduplication giúp các định chế tài chính siết chặt an ninh thông tin thông qua việc quản lý định danh trên một bản ghi duy nhất, đồng thời giải phóng đáng kể năng lực tính toán cho các quy trình rà soát phòng chống gian lận.
Thực tế cho thấy, một tổ chức tài chính đã ứng dụng quy trình khử trùng lặp dữ liệu để tinh gọn bộ máy Disaster Recovery. Khi sự cố mất dữ liệu xảy ra, bộ dữ liệu backup có dung lượng nhỏ (do đã được khử trùng lặp hoàn toàn) giúp quá trình truyền tải và khôi phục hệ thống diễn ra nhanh chóng, giảm thiểu tối đa thời gian gián đoạn hoạt động kinh doanh.
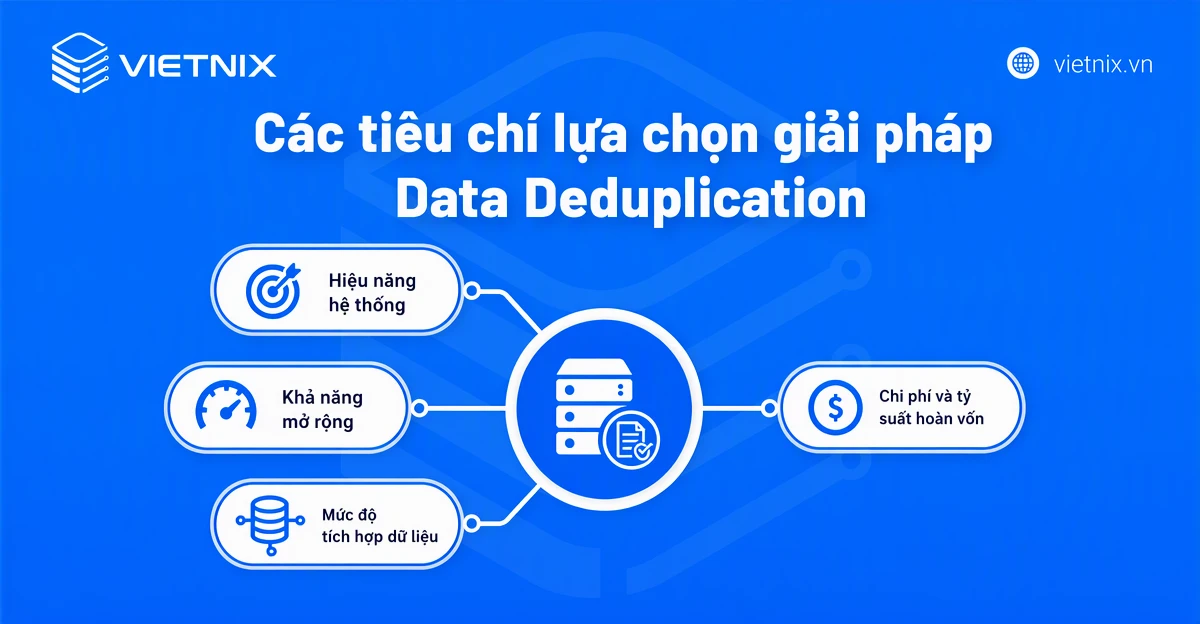
Các tiêu chí lựa chọn giải pháp Data Deduplication
Khi triển khai Data Deduplication, việc chọn đúng phương pháp và công cụ sẽ quyết định tính hiệu quả của toàn bộ hệ thống quản trị dữ liệu. Dưới đây là các tiêu chí kỹ thuật và nghiệp vụ cần cân nhắc để đảm bảo hệ thống vận hành ổn định, đáp ứng đúng nhu cầu tổ chức.
1. Hiệu năng hệ thống
Mức tiêu thụ tài nguyên tỷ lệ thuận với phương pháp triển khai. Điển hình, cơ chế xử lý cấp độ khối tại nguồn (source-based, block-level) sẽ tiêu tốn năng lực điện toán cao hơn đáng kể so với phương pháp xử lý cấp độ tệp tại đích (target-based, file-level).
2. Khả năng mở rộng
Tiến trình dedupe càng đòi hỏi nhiều sức mạnh xử lý thì hệ thống càng gặp khó khăn khi mở rộng. Doanh nghiệp cần cân bằng giữa độ chính xác của thuật toán áp dụng và năng lực đáp ứng lộ trình tăng trưởng khối lượng dữ liệu trong tương lai.
3. Mức độ tích hợp dữ liệu
Tình trạng phân mảnh cơ sở dữ liệu làm giảm trực tiếp hiệu quả của quá trình khử trùng lặp. Đặc biệt với kiến trúc phân tán, tổ chức buộc phải thiết lập các quy trình làm sạch và chuẩn hóa dữ liệu trước khi thực thi lệnh dedupe.
4. Chi phí và tỷ suất hoàn vốn
Chi phí cấp phép thường biến thiên theo tính năng và tỷ lệ thuận với khối lượng bản ghi cần xử lý. Đội ngũ dự án cần hoạch định tổng chi phí sở hữu (TCO) và đối chiếu với tỷ suất hoàn vốn (ROI) dựa trên phần ngân sách phần cứng lưu trữ tiết kiệm được trong dài hạn.
Từ thực tế vận hành
Không nên phó mặc việc khử trùng lặp cho các nhà cung cấp Public Cloud vì người dùng vẫn phải trả phí truyền tải cho tổng dung lượng gốc. Việc xử lý Deduplication ngay tại nguồn (source-based) trước khi đẩy lên Cloud sẽ mang lại hiệu quả chi phí cao nhất.
Vietnix – Hạ tầng VPS và Server cho hệ thống lưu trữ ứng dụng Data Deduplication
Tiến trình Khử trùng lặp dữ liệu yêu cầu khả năng xử lý I/O cường độ cao và năng lực điện toán lớn. Giải pháp cho thuê máy chủ vật lý và dịch vụ VPS tại Vietnix được cấu trúc để đáp ứng trực tiếp các tiêu chuẩn kỹ thuật này thông qua các nền tảng sau:
- Trung tâm dữ liệu chuẩn Tier 3: Toàn bộ hệ thống máy chủ được đặt tại Datacenter chuẩn Tier 3, đảm bảo tính sẵn sàng cao với nguồn điện, hệ thống làm mát và kết nối mạng dự phòng liên tục, đáp ứng tiêu chuẩn vận hành môi trường lưu trữ lõi.
- Hệ thống lưu trữ NVMe SSD: Sử dụng 100% ổ cứng NVMe SSD cung cấp tốc độ truy xuất và chỉ số IOPS vượt trội. Cấu hình này giải quyết triệt để rào cản hiệu năng trong quá trình hệ thống thực thi tính toán mã băm và đối chiếu khối dữ liệu liên tục.
- Cơ chế sao lưu định kỳ: Tích hợp quy trình sao lưu tự động hóa, đảm bảo an toàn cho các cấu trúc siêu dữ liệu quan trọng như tệp vân tay và bảng tham chiếu duy trì khả năng khôi phục hệ thống chính xác khi xảy ra sự cố.
- Giám sát và hỗ trợ 24/7: Đội ngũ kỹ thuật túc trực liên tục để giám sát hiệu suất hạ tầng, hỗ trợ đảm bảo tài nguyên phần cứng luôn vận hành ổn định xuyên suốt.
Liên hệ bộ phận kỹ thuật Vietnix để nhận tư vấn cấu trúc hạ tầng và lựa chọn tài nguyên Server/VPS phù hợp cho bài toán lưu trữ của doanh nghiệp.
Thông tin liên hệ:
- Website: https://vietnix.vn/
- Hotline: 1800 1093
- Email: sales@vietnix.vn
- Địa chỉ: 265 Hồng Lạc, Phường Bảy Hiền, Thành Phố Hồ Chí Minh
Câu hỏi thường gặp
Khi nào không nên áp dụng Data Deduplication?
Bạn không nên áp dụng quá trình khử trùng lặp dữ liệu cho các phân vùng lưu trữ chính hoặc môi trường production ưu tiên hiệu suất cao. Quá trình phân tích và tạo mã hash liên tục sinh ra overhead, có thể gây tác động tiêu cực đến tốc độ truy xuất và xử lý dữ liệu của hệ thống.
Data Deduplication có làm mất dữ liệu gốc không?
Không, Data Deduplication là công nghệ nén lossless (không mất mát dữ liệu). Hệ thống sẽ giữ lại một bản sao duy nhất và tạo các con trỏ tham chiếu đến bản ghi đó. Đối với cơ sở dữ liệu, các thông tin quan trọng từ bản ghi bị loại bỏ sẽ được gộp vào bản ghi chính trước khi tiến hành xóa, đảm bảo tính toàn vẹn của thông tin.
Nên deduplicate dữ liệu trước hay sau khi mã hóa/nén?
Nên thực hiện Data Deduplication trước khi nén hoặc đồng bộ dữ liệu. Việc loại bỏ các khối dữ liệu trùng lặp ở nguồn giúp thu gọn đáng kể kích thước dataset, từ đó giảm băng thông mạng cần thiết và hạ thấp chi phí lưu trữ khi chuyển dữ liệu lên cloud.
Deduplication cấp file và cấp block khác nhau như thế nào?
Ở cấp độ file, nếu một bit dữ liệu thay đổi, hệ thống sẽ lưu lại toàn bộ một bản sao mới của file đó, dẫn đến hiệu suất tối ưu kém. Ngược lại, deduplication cấp block chia nhỏ dữ liệu thành các đoạn. Khi có thay đổi, chỉ những block chứa dữ liệu mới được lưu lại, giúp tiết kiệm không gian lưu trữ hiệu quả hơn nhiều lần.
Tỷ lệ deduplication bao nhiêu là tốt?
Mức tỷ lệ tối ưu phụ thuộc vào loại dữ liệu và mục đích sử dụng. Trong nhiều hệ thống backup, tỷ lệ khử trùng lặp có thể đạt 25:1. Với tỷ lệ này, hệ thống có khả năng lưu trữ 250GB dữ liệu thực tế chỉ trên 10GB dung lượng đĩa vật lý, mang lại hiệu quả tối ưu chi phí cực lớn.
Data Deduplication có ảnh hưởng đến thời gian khôi phục dữ liệu không?
Có, công nghệ này tác động tích cực đến quá trình phục hồi dữ liệu. Do các dataset sau khi khử trùng lặp có kích thước nhỏ hơn đáng kể, thời gian chuyển giao dữ liệu (data transfer) trong các kịch bản disaster recovery được rút ngắn, giúp khôi phục hệ thống nhanh chóng và giảm thiểu thời gian downtime.
Data Deduplication có phù hợp với cơ sở dữ liệu giao dịch thời gian thực không?
Data Deduplication thường không được khuyến nghị cho cơ sở dữ liệu giao dịch thời gian thực. Các môi trường này yêu cầu tốc độ phản hồi cực kỳ nhanh, trong khi thuật toán tính toán mã hash và phân tích block của deduplication sẽ tạo ra độ trễ, làm giảm hiệu năng tổng thể của quá trình xử lý giao dịch.
Có nên bật Data Deduplication cho mọi loại dữ liệu không?
Không nhất thiết. Việc triển khai khử trùng lặp chỉ thực sự phát huy hiệu quả ở các phân vùng lưu trữ phụ dùng cho mục đích sao lưu hoặc lưu trữ. Đây là những nơi tập trung số lượng lớn dữ liệu trùng lặp và đặt mục tiêu tối ưu chi phí lên hàng đầu.
Doanh nghiệp nhỏ có cần Data Deduplication không?
Bất kỳ tổ chức nào cũng phải đối mặt với tình trạng dư thừa dữ liệu phát sinh từ lỗi nhập liệu thủ công, di chuyển hệ thống hoặc tích hợp từ nhiều nguồn. Việc thiết lập quy trình deduplication tự động sẽ giúp doanh nghiệp nhỏ duy trì chất lượng dữ liệu, tăng tốc độ truy vấn và kiểm soát chi phí lưu trữ hiệu quả.
Data Deduplication là giải pháp kỹ thuật cần thiết giúp loại bỏ các bản sao dư thừa, từ đó tối ưu hóa không gian lưu trữ và nâng cao chất lượng dữ liệu tổng thể. Việc triển khai quy trình này thường xuyên không chỉ giảm thiểu chi phí mà còn tăng tốc độ truy xuất thông tin cho toàn bộ hệ thống, đồng thời hỗ trợ quá trình sao lưu và khôi phục diễn ra nhanh chóng, an toàn hơn. Dù lựa chọn phương pháp on-demand, automated hay preventative, doanh nghiệp cũng nên xây dựng cho mình một chiến lược deduplication nhất quán, kết hợp cùng các chính sách quản trị dữ liệu phù hợp để duy trì sự chính xác và ổn định trong dài hạn.

THEO DÕI VÀ CẬP NHẬT CHỦ ĐỀ BẠN QUAN TÂM
Đăng ký ngay để nhận những thông tin mới nhất từ blog của chúng tôi. Đừng bỏ lỡ cơ hội truy cập kiến thức và tin tức hàng ngày
Đánh giá mức độ hữu ích của bài viết

Thất vọng

Chưa hữu ích

Bình thường

Hữu ích

Rất hữu ích